 桑治
我的角色工具开发、流程设计与 AI 协作
当前阶段持续使用与迭代
技术与方法Python / Qwen3-ASR / vLLM / FFmpeg / CLI / MCP
一开始,只有文件转换
我一开始只有文件转换工具,让 AI 可以通过命令把 PDF、PPT、Word 等材料转换成图片。
课件里有很多图表、公式和版式信息,单纯提取文字容易丢掉这些内容。所以我选择让 AI 直接看图片,保留页面上原有的信息。
为了提高效率,我又增加了拼接图。AI 会先看拼接图,在看不清的情况下,再继续看分开的单张。这时 AI 的理解和判断就派上了用场:它可以判断图片是不是看得清,再决定下一步操作。
工具负责转换和拼接,AI 根据实际看到的内容决定需要读到什么程度。
把重复的提示词整理成规范
有了文件处理,每次整理笔记,我还是要重新写提示词,比较麻烦。但很多要求是通用的,所以我制定了笔记整理规范,每门课只需要根据课程差别微调。
比如,笔记要怎样组织知识、怎样解释图表、怎样保留来源、图片放在哪里。这些要求写进规范之后,AI 可以结合课程内容来执行,我再通过阅读和使用继续调整。
课件之外,还需要老师实际讲的内容
后来发现,课件内容老师不一定全讲,课堂重点也不一定全部在课件上。
于是我借助 AI 分析录播平台的请求,发现课程信息、课次和视频资源可以通过接口获取,便封装成脚本。现在可以按课程名称、日期或课次定位本人有权限访问的材料,再下载对应录播和课件,减少手动查找和点击。
下载工具还处理完整性检查、网络失败重试和断点续传,让后续整理可以接着已有材料进行。
有了视频,何不用专门的语音识别模型?
当时我使用的通用模型,对音频的处理能力和接入方式比较有限,那何不用专门的 ASR(Automatic Speech Recognition,自动语音识别)模型?
我先后试用了 Whisper 和 Qwen3-ASR。在我的中文课堂材料里,Qwen 对专业术语和中英文混合内容的效果更符合需要,因此后续选择了 Qwen3-ASR-1.7B。
但本地运行也有新的问题:我的 RTX 4060 Laptop 只有 8GB 显存,长音频的单次处理开销较大。怎么处理?先切片,把音频拆成不超过2.5分钟的小段。
单片段的速度问题还在,于是又使用 vLLM 推理服务,同时提交多个片段,提高整体吞吐。当前默认是5路请求并发,由同一个服务调度。
如果在老师说话时切断怎么办?
这个问题也考虑到了。我增加了声音强度判断,在2–2.5分钟的区间内寻找靠近上限的低能量位置,尽量减少在说话过程中切断。
接着又考虑:一个分片如果几乎没有说话,能不能直接跳过?无声输入有时会让模型反复输出相似内容,拖慢转录。于是加入语音活动检测,累计人声不足2秒的片段跳过请求,并保留它在原音频中的时间位置;输出再处理连续重复的内容。
这些调整之后,我在本机处理90分钟音频时,转录耗时约4.3分钟,约21倍实时速率。
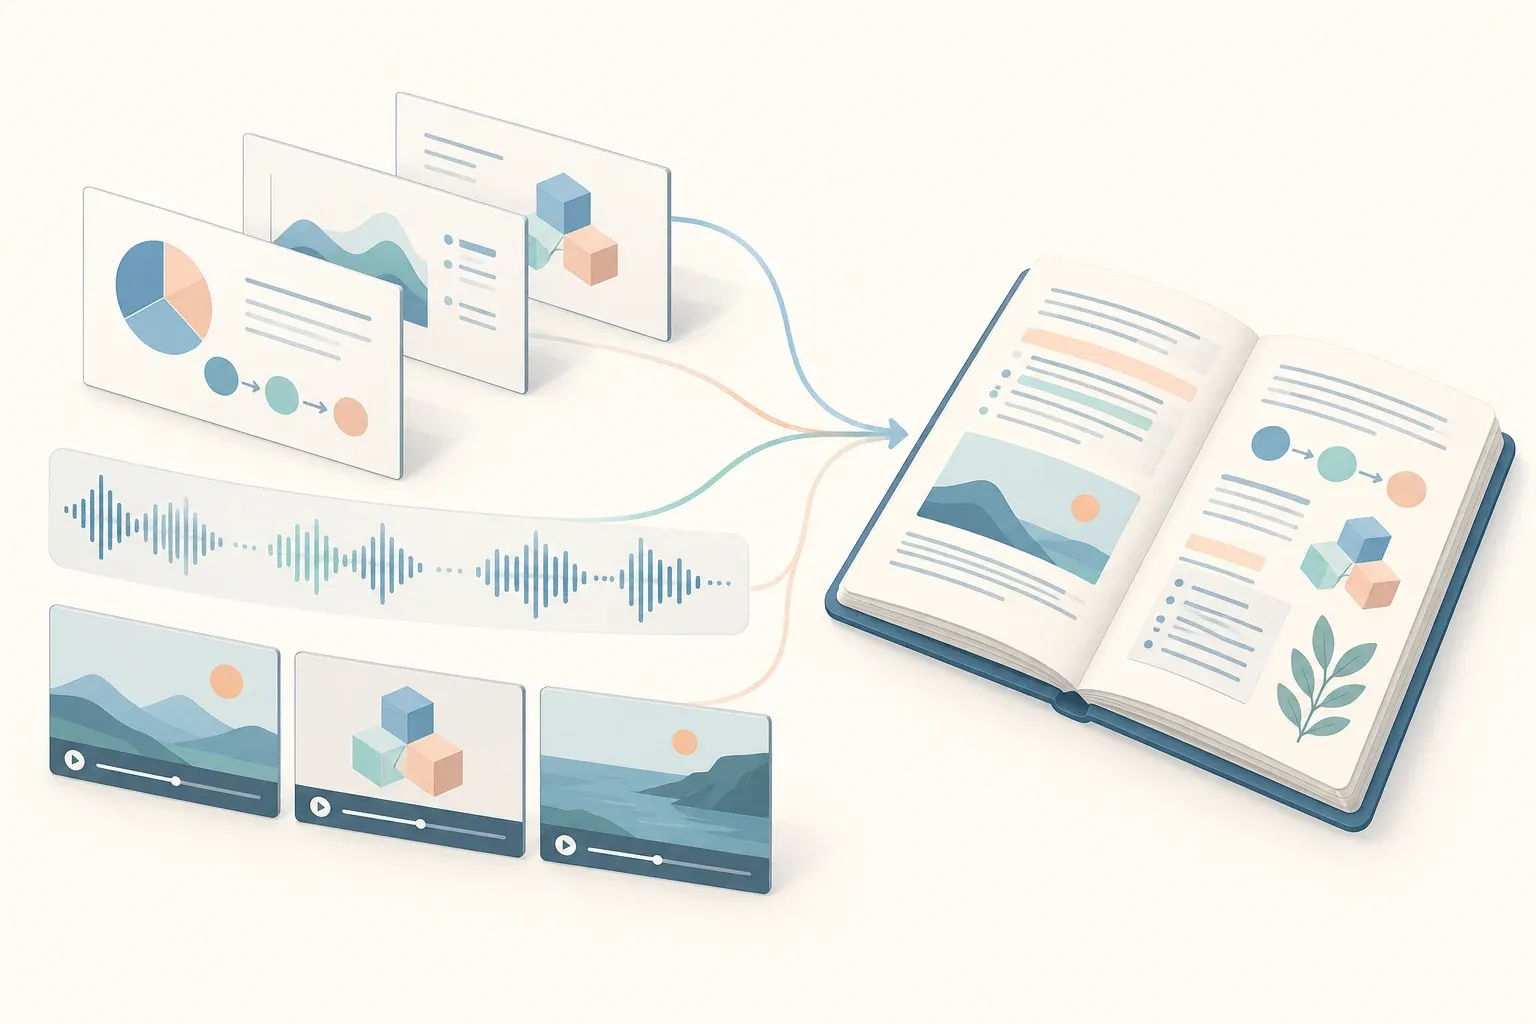
有了课堂转录和课件,AI 就可以按照之前的规范,整理包含课堂重点、配有相关课件图片的笔记。
只有音频还不够,能不能也看视频画面?
在这个基础上,我又在想:如果一门课没有课件,或者老师在演示操作,只听音频是不是还不够?
我选择在现有转录基础上增加画面处理。图片便于局部读取,所用视觉模型也可以直接查看,不必每次都提交整段视频。
Qwen3-ForcedAligner-0.6B 可以对音频和文字作词/字级时间对齐。把结果组织成短句索引之后,就能定位每句话对应的时间。
这时 AI 的语义理解又派上用场了:它可以根据句子内容,判断是不是需要查看对应时间段的画面。需要时,用 FFmpeg 在那个时间区间抽取几张候选帧,实际看一看是不是需要的内容;如果画面还没展示完整,就继续调整时间或增加取样。
我也专门整理了视频图文笔记规范,把材料获取、转录、时间定位、抽帧、选图和成文串起来。工具执行明确操作,AI 判断什么时候需要看、看什么,以及怎样把内容写进笔记。
提供流程和工具,让 AI 参与判断
这个过程中,我逐渐感受到 AI 的理解能力和适应不同材料的价值。你无需把每种情况都硬编码:提供必要的工具,规定处理流程和输出要求,AI 就可以根据具体内容选择下一步。
这套学习自动化也在继续扩展。我还开发了 Canvas 课程助手,通过命令行和 MCP(Model Context Protocol,模型上下文协议)查询课程、作业、反馈和资料;并整理了录播、选课点评与课表工具的统一入口。它们共同服务于我的学习过程。
从一节分治法课到图文笔记展示了已有课堂转录、课件页码和章节笔记之间的对应关系。
模型、教学平台和媒体处理引擎使用已有方案;我的工作主要是围绕自己的学习需要开发工具、设计规范、连接流程,并在实际使用中持续改进。